Architecture > Module Web sémantique
Sommaire
Introduction
Le module a pour objectif la diffusion de données dans un formalisme compatible avec les standards du web sémantique.
- Site de démo: https://simm.e-is.pro/api
Pour découvrir le web sémantique : voir ce cours en ligne proposé par l'INRIA (en accès libre).
Fonctionnalités
Point d'accès SparQL
Le module rend accessible un "SparQL endpoint".
Celui-ci répond aux requêtes HTTP (GET ou POST) envoyées au serveur sur le chemin <SERVER_URL>/sparql (par exemple http://localhost:8080/sparql).
Ce endpoint est utilisable dans n'importe quel éditeur SparQL, ou depuis une requête HTTP quelconque.
Le format de la réponse est détecté automatiquement, à partir de l'entête HTTP Accept de la requête, comme le prévoit l'usage de SparQL (Content-Type negociation).
Les formats de réponse suivants sont possibles :
-
Format spécifique SparQL, pour les requêtes de type
SELECTetASK:Format Header Accept(Content-Type)SparQL-results XML application/sparql-results+xml,application/xml,text/xmlSparQL-results JSON application/sparql-results+json,application/jsonSparQL-results CSV application/sparql-results+csv,text/csvSparQL-results TSV application/sparql-results+tsv,text/tab-separated-values,text/html,text/plainSparQL-results SSE application/sparql-results+sseSparQL-results Thrift application/sparql-results+thrift -
Formats standards RDF, pour les requêtes de type
CONSTRUCTetDESCRIBE:Format Header Accept(Content-Type)RDF/XML application/rdf+xml,application/xml,text/xmlRDF/JSON application/rdf+json,application/json,application/json;charset=UTF8JSON-LD application/ld+jsonN3 text/rdf+n3NTriple application/n-triplesNQuads application/n-quadsTrig text/trig,application/trigTriX text/trix,application/trixTurtle text/turtle,application/ttlText text/plain,text/html
Un éditeur SparQL est disponible à l'adresse
SERVER_URL/sparql/uipour tester le point d'accès SparQL. Des requêtes d'exemples y sont également accessibles. (démo)
Exemples de requêtes SparQL:
-
Requête
SELECT(HTTP GET) avec un retour enSparQL results XML:curl -H 'Accept: application/sparql-results+xml' \ 'http://simm.e-is.pro/sparql?query=PREFIX%20sar%3A%20%3Chttp%3A%2F%2Fsimm.e-is.pro%2Fontology%2Fschema%2F%3E%0APREFIX%20dwctax%3A%20%3Chttp%3A%2F%2Frs.tdwg.org%2Fontology%2Fvoc%2FTaxonName%23%3E%0APREFIX%20dwc%3A%20%3Chttp%3A%2F%2Frs.tdwg.org%2Fdwc%2Fterms%2F%3E%0APREFIX%20rdf%3A%20%3Chttp%3A%2F%2Fwww.w3.org%2F1999%2F02%2F22-rdf-syntax-ns%23%3E%0ASELECT%20DISTINCT%20*%0AWHERE%20%7B%0A%20%20%3Fsub%20rdf%3Atype%20%3Ftype%20%3B%20%0A%20%20%20%20%20%20%20dwc%3AscientificName%20%3Flabel%20.%20%20%0A%7D%20LIMIT%2010' -
Requête
CONSTRUCT(HTTP POST) avec un retour enTurtle:curl -H 'Accept: text/turtle' 'http://simm.e-is.pro/sparql' \ --data-raw 'query=PREFIX%20sar%3A%20%3Chttp%3A%2F%2Fsimm.e-is.pro%2Fontology%2Fschema%2F%3E%0APREFIX%20dwctax%3A%20%3Chttp%3A%2F%2Frs.tdwg.org%2Fontology%2Fvoc%2FTaxonName%23%3E%0APREFIX%20dwc%3A%20%3Chttp%3A%2F%2Frs.tdwg.org%2Fdwc%2Fterms%2F%3E%0APREFIX%20rdf%3A%20%3Chttp%3A%2F%2Fwww.w3.org%2F1999%2F02%2F22-rdf-syntax-ns%23%3E%0ACONSTRUCT%20%7B%0A%20%20%3Fsub%20rdf%3Atype%20dwctax%3ATaxonName%20%3B%0A%09dwc%3AscientificName%20%3Flabel%20.%0A%7D%0AWHERE%20%7B%0A%20%20%3Fsub%20rdf%3Atype%20%3Ftype%20%3B%20%0A%20%20%20%20%20%20%20dwc%3AscientificName%20%3Flabel%20.%20%20%0A%7D%20LIMIT%2010'
Triple store
Le SparQL endpoint permet l'accès aux triplets stockés dans un "triple store" Apache Jena TDB2.
Ceci rend accessible des jeux de données (datasets) chargés et mis à jour. Plusieurs types de chargement sont possible :
- Chargement depuis une ou plusieurs bases de données (ex: table de référentiels);
- Chargement à interrogation de "SparQL endpoints" distants, via des requetes (de type
CONSTRUCT) stockées en fichier; - Chargement depuis des fichiers RDF;
- etc.
Chaque jeu de données est isolé dans un sous-ensemble (dit "named graph"), pour permettre de les requéter indépendamment, par sous-ensemble, à partir d'une requête du type :
SELECT ...
FROM NAMED GRAPH <URI>   <-- URI du sous-ensemble à requeter
WHERE ...`
Recherche fédérée
Il est possible de requêter des endpoints SparQL tiers, et d'interroger leur jeux de données.
Exemple de requête SparQL fédérée :
SELECT * FROM
WHERE {
 SERVICE <http://taxref.mnhn.fr/sparql> {

 }
}
Synchronisation
Le module permet de mettre à jour automatiquement le triple store, notamment :
- A chaque re-démarrage du serveur;
- en cron - à une période données - TODO: à implémenter.
Le chargement des données peut se faire depuis plusieurs sources :
- depuis une ou plusieurs BDD;
- des endpoints SparQL distants,
- des fichiers locaux;
- etc.
L'importation via un fichier de configuration.
TODO :
- implémneter le cron
- gérer la détection des mises à jour (import incrémental - nécessite une date de dernière mise à jour)
Conversion d'ontologies
Le module offre une fonctionnalité de conversion, de n'importe quel format de modèle RDF, vers les formats supportés par le endpoint SparQL.
Cette fonction est accessible depuis le chemin <SERVER_URL>/ontology/convert, avec les paramètres suivants :
uri: l'URL du modèle à convertir;sourceFormat(optionnel) : le format du fichier source, nécessaire uniquement si aucun extension n'est présente; et si aucune négociatio de contenu n'est disponible sur l'URL;format(optionnel): le format de sortie attendu. Optionnel, si l'entete HTTPAcceptdéfinir les format de sortie attendus (négociation de contenu).
Exemples de conversion:
- Convertir FOAF en VOWL, via une déclaration explicite du format:
curl 'http://simm.e-is.pro/ontology/convert?uri=http://xmlns.com/foaf/spec/&format=vowl' - Convertir APT (référentiel "Appellations Taxonomiques" du Sandre) en RDF/XML, en utilisant une entête HTTP:
curl -H 'Accept: application/rdf+xml'  \
  'http://simm.e-is.pro/ontology/convert?uri=http://owl.sandre.eaufrance.fr/apt/2.1/sandre_fmt_owl_apt.owl'
L'outil de visusalition WebVowl est disponible à l'adresse
<SERVER_URL>/webvowl, et exploite cette fonction de conversion, afin de rendre visualisable n'importe quel modèle d'ointologie disponible sur le net. (démo)
Publication d'ontologies
Le module permet de publier, sous forme d'ontologie, un modèle de données issu d'une BDD.
Pour cela, le module autorise l'accès (HTTP GET) aux adresses suivantes :
<SERVER_URL>/ontology/schema: publication du schéma entier (Classes et attributs)<SERVER_URL>/ontology/schema/<CLASSE>: publication d'une classe, de ses attributs, et de ses classes directement connectées;
Le format de sortie dépend de la présence de l'entête HTTP Accept.
Il est également possible de définir explictement : soit en ajoutant ?format=FORMAT au chemin, soit en ajoutant une extension.
Exemples :
- http://localhost:8080/ontology/schema
- http://localhost:8080/ontology/schema.ttl
- http://localhost:8080/ontology/schema?format=ttl
- http://localhost:8080/ontology/schema/TaxonName
- http://localhost:8080/ontology/schema/TaxonName.ttl
- http://localhost:8080/ontology/schema/TaxonName?format=ttl
Les formats de réponse suivants sont possibles :
| Format | extension ou format | Header Accept (Content-Type) |
|---|---|---|
| RDF/XML | xml, rdf |
application/rdf+xml, application/xml, text/xml |
| RDF/JSON | json |
application/rdf+json, application/json, application/json;charset=UTF8 |
| JSON-LD | jsonld, json-ld |
application/ld+json |
| N3 | rdf/n3, n3 |
text/rdf+n3 |
| NTriple | nt, ntriples, n-triples |
application/n-triples |
| NQuads | nq, nquads, n-quads |
application/n-quads |
| OWL | owl |
application/xml+owl |
| Trig | trig |
text/trig, application/trig |
| TriX | trix |
text/trix, application/trix |
| Turtle | ttl, turtle |
text/turtle, application/ttl |
| Thrift | thrift, rt, trdf |
application/rdf+thrift, application/x-thrift, application/rdf+x-thrift, application/vnd.apache.thrift.binary |
| VOWL | vowl |
application/webvowl+json |
Un outil est disponible à l'adresse
<SERVER_URL>/ontologypour construire et tester les différents chemins, options et format possibles. (démo)Une visualisation graphique d'ontologies y est également possible (en cliquant sur le bouton "View WebVowl")
Publication de données
Le module permet d'accéder à des données d'une base de données sous-jacente, par exemple aux tables de référentiel.
Pour cela, le module autorise l'accès (HTTP GET) aux adresses suivantes :
<SERVER_URL>/ontology/data/<CLASSE>: toutes les instances correspondante à la classe;<SERVER_URL>/ontology/data/<CLASSE>/<ID>: une seule instances de classe;
Il est possible de définir le format de sortie via une entête HTTP Accept dans la requete GET.
Il est également possible de le définir explictement : soit en ajoutant ?format=<FORMAT> au chemin, soit en ajoutant une extension.
Exemples :
- http://localhost:8080/ontology/data/TaxonName
- http://localhost:8080/ontology/data/TaxonName.ttl
- http://localhost:8080/ontology/data/TaxonName?format=ttl
- http://localhost:8080/ontology/data/TaxonName/15151
- http://localhost:8080/ontology/data/TaxonName/15151.ttl
- http://localhost:8080/ontology/data/TaxonName/15151?format=ttl
Un outil est disponible à l'adresse
<SERVER_URL>/ontologypour construire et tester les différents chemins, options et format possibles. (démo)
Implémentation technique
Libraries et frameworks
Voici les librairies et frameworks utilisés par l'implémentation du module :
- Apache Jena :
- Core API (v3.14 ou +):
- Pour lire/écrire et manipuler des modèles RDF;
- Pour convertir les modèles RDF en différents format (RDF/XML, RDF/JSON, JSONLD, ...);
- TDB2 (v3.14 ou +): comme "triplestore" permettant la persistence des données sémantiques;
- Core API (v3.14 ou +):
- OWLAPI
- Pour les conversions au format OWL (tags xML OWL sans les balises RDF)
- Owl2Vowl:
- Pour les conversions au format VOWL, utilisé par WebVOWL (outil visualisation graphique d'ontologies) ;
- Spring Boot :
- Pour implémenter les points d'accès HTTP REST (GET ou POST), sous forme de Serlvet JEE;
- Déployable au sein d'un moteur Apache Tomcat, et/ou d'une autre application web utilisant Spring Boot;
- La gestion de la sécurité utilise Spring Security, pour contrôler les éventuels droits d'accès par authentificaiton.
- Apache Maven :
- Pour la gestion des dépendances Java, la compilation et livraison du module;
Composants logiciels
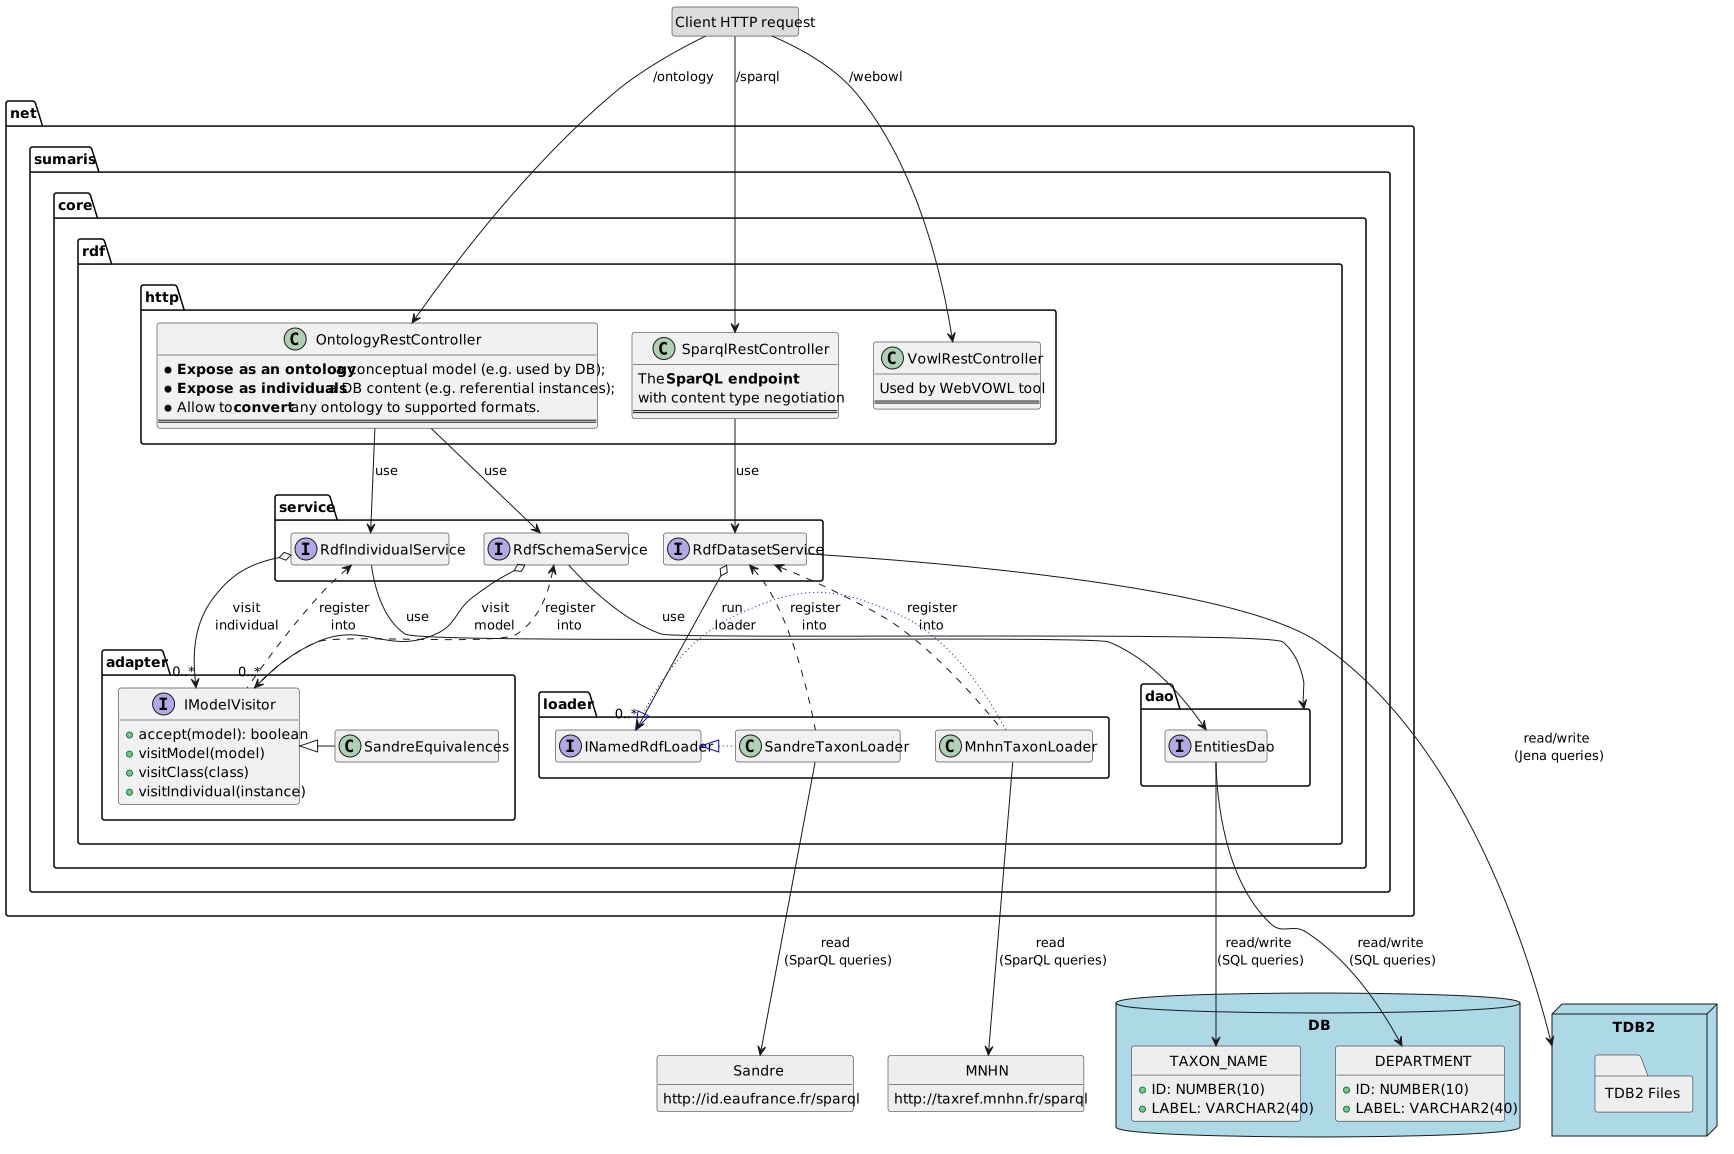
Le module est divisé en composants logiciels, illustrés ci-dessous :
package http
Le package http est responsable de répondre aux requetes HTTP (GET et/ou POST) recus par le serveur.
Il analyse également le format de sortie attendu par la requete, via les entêtes HTTP Accept, l'extension ou le paramètre format.
Chaque RestController délègue ensuite, suivant le type de demande, la création ou la récupration d'un modèle Jena à un service spécialisé.
Dans le cas du SparQLRestController, la requête SparQL est d'abord nettoyée, puis executé (via TDB2 ou une endpoint distant).
Le résultat est, si besoin, assemblé en un nouveau modèle Jena.
Quelque soit composant RestController, une fois le modèle Jena récupéré, une sérialisation du mdoèle vers le format de sortie attendu est appliquée.
package service
Le package service concentrent les fonction de chargement et de transformation de modèle.
En particulier, les modèles résultant de la BDD locale proviennent de RdfSchemaService et RdfIndividualService,
respectivement pour la définition de l'ontologie du modèle de données, et des données en elle même.
Les modèles Jena transitants par ces services sont extensibles, via le pattern Visitor. Par exemple, pour y associer
des correspondances avec d'autres ontologies (FOAF, RDFS, ORG, ...).
Les composants Service bénéficient également d'un cache applicatif, pour optimiser leur performance.
Chaque demande est ainsi converti en hashCode pour servir de clef d'accès à ce cache, qui dépendra donc de chaque
option utilisée pour la génération du modèle Jena.
Le service RdfDatasetService est responsable de l'initailisation TripleStore local (TDB2). Il peut charger des données distantes,
en déléguant les requetes d'accès à des composants NamedRdfLoader (cf package loader ci-dessous).
Il est également responsable de l'execution des requetes SparQL non distantes, sur le TripleStore local.
package loader
Ce package permet d'ajouter simplement de nouveaux endpoints distants, pour importer leur données dans le TripleStore local.
Chaque composant implémentant l'interface INamedRdfLoader précise le endpoint à appeller, et la requête SaprQL CONSTRUCT
(ou le fichier de requete) à executer sur celui-ci.
Pour éviter tout problème mémoire, l'importation des données est paginée. Chaque loader peut cependant préciser le nombre maximum d'éléments dans une page (10000 par défaut).
/**
* Exemple de INamedRdfLoader pour charger les taxons depuis le SparQL endpoint du Sandre
**/
@Component("sandreTaxonLoader")
public class SandreTaxonRdfLoader extends AbstractNamedRdfLoader {

    private static final Logger log = LoggerFactory.getLogger(SandreTaxonRdfLoader.class);

    @Value("${rdf.sandre.sparql.endpoint:http://id.eaufrance.fr/sparql}")
    private String endpointUrl;

    @Value("${rdf.sandre.sparql.limit:10000}")
    private int fetchSize = 10000;

    @Value("${rdf.dataset.sandre.apt.name:http://id.eaufrance.fr/apt/}")
    private String name;

    @Value("${rdf.dataset.sandre.apt.query:classpath:sparql/taxon.sparql}")
    private String queryFile;

    // ...
}
package adapter
Le package adapter regroupe les composants qui viennent enrichir l'ontologie et les instances de données diffusées par le serveur,
à partir du schéma et des donnée de la BDD sous-jacente.
Ils concernent exclusivement les classes d'entités (Entités JPA - cf package dao) du modèle de données de la BDD.
Chaque classe du modèle de données (par exemple TaxonName, Department) peut se voir ajouter des correspondances
avec des ontologies connus.
Les équivalences ajouté peuvent être de différentes nature. Le plus souvent, il s'agit :
- Pour une ontologie portant sur un schéma :
rdfs:subClassOfouowl:equivalentClassrdfs:subPropertyOfouowl:equivalentProperty
- Pour des instances (individuals) :
skos:exactMatchouowl:sameAs
/**
* Exemple d'ajout de correspondances FOAF (Friend Of A Friend) sur la classe Department.
**/
@Component("foafSchemaEquivalences")
public class FoafSchemaEquivalences
    implements IModelVisitor<Model, RdfSchemaFetchOptions> {
  // ...

  @Override
  public void visitClass(Model model, Resource ontClass, Class clazz) {

    // ...

    if (clazz == Department.class) {
        // FOAF.Organization = Department
        ontClass.addProperty(equivalentClass, FOAF.Organization);

        // FOAF.homepage = Department.site
        model.getResource(classUri + "#" + Department.Fields.SITE_URL)
                .addProperty(equivalentProperty, FOAF.homepage);
    }
  }
}
package dao
Le composant EntitiesDao offre une accès générique au modèle de données de la base de données.
Il permet également de requéter les données tables associées.
Pour fonctionner, EntitiesDao a besoin d'entité du format JPA (Java Persistence API - utilisé par Hibernate), afin
d'accéder à la BDD via des classes et objets Java. Les requêtes générées utilise egalement un formalisme objet (JPA-QL ou HQL)
package util
Un package util (non représenté sur l'illustration des composants logiciels) contient des utilitaires qui permettent :
- La manipulation de modèle, vers tous les formats compatibles (y compris non standards, comme WebVOWL);
- La correspondance entre les entêtes HTTP
Accept(Content-Type) et les format Jena; - La conversion d'entité JPA (classes et instances de classes) en ontologie Jena ;
- etc.
Sécurité
La gestion des droits d'accès peut se faire sur chaque endpoint REST, grâce à des annotations Java et Spring Security. On peut ainsi limiter l'accès, au cas pas cas, par exemple pour autoriser uniquement certains profils d'utilisateur.
Pour le moment, l'écriture dans le triplestore et dans la BDD n'étant pas implémenté, les endpoints en accessible à tous, sans authentification.
Configuration
Le module est activable par l'option de configuration rdf.enabled.
Autres options disponibles :
| Propriété | Description | Valeur par défaut |
|---|---|---|
rdf.model.version |
Version du modèle | 2019-11-20 |
rdf.model.date |
Date du modèle | 2019-11-20 |
rdf.model.prefix |
Namespace de l'ontologie générée | sar |
rdf.model.baseUri |
URI de l'ontologie générée | ${server.url}/ontology/ |
rdf.model.license |
Licence de l'ontologie générée | http://www.gnu.org/licenses/gpl-3.0.html |
rdf.model.authors |
Auteur de l'ontologie générée | ${sumaris.organizationName} |
rdf.model.publisher |
Editeur de l'ontologie générée | ${sumaris.site.url} |
rdf.tdb2.enabled |
Utiliser TDB2 ? Si désactivé, un TripleStore en mémoire sera utilisé. | true |
rdf.data.import.enabled |
Importer les données de la BDD dans le TripleStore ? | true |
rdf.data.import.entities |
Classes d'entités de la BDD à importer, séparée par une virgule | TaxonName,Department,Gear |
rdf.data.import.external.enabled |
Importer les données distantes (cf package loader) |
true |
rdf.data.import.entities |
Classes d'entités de la BDD à importer, séparée par une virgule | TaxonName,Department,Gear |
rdf.data.import.entities |
Classes d'entités de la BDD à importer, séparée par une virgule | TaxonName,Department,Gear |
rdf.data.pageSize.default |
Nombre limite d'éléments renvoyé par une requête SparQL, si non spécifié dans celle-ci | 100 |
rdf.data.pageSize.max |
Nombre limite d'éléments renvoyé par une requête SparQL | 10000 |
rdf.data.pageSize.max |
Nombre limite d'éléments renvoyé par une requête SparQL | 10000 |
rdf.directory |
Répertoire de travail de TDB2 | ${sumaris.data.directory}/rdf |
rdf.tdb2.directory |
Répertoire de travail de TDB2 | ${rdf.directory}/tdb2 |